本文为转载整理,原视频来自抖音 @亚莱加德:ai界的RSI它来了(2026-10-21,49 秒)。视频本身只讲了 7 个画面要点,正文里的八个组件清单、Propose–Probe–Compose 的具体流程与 benchmark 口径,是我按官方 README 和 论文 补的;两者不一致的地方已在正文里标出。本站仅做学习归档,不做商用。
Harness 是外壳,Harnessing 是改外壳
这轮讨论里最容易糊掉的是两个词。论文开头就把它们定义得很干脆:harness 指的是围绕模型的那一整套东西——提示词、工具、记忆、技能、编排,凡是让模型能「当一个 agent 用」的都在里面;harnessing 则是对这套东西做优化的过程。
所以 Harness² 要解决的问题,不是「怎么让模型更聪明」,而是「怎么让模型外面那层壳自己变好」。这个区分很关键,因为它决定了后面所有的技术选择:壳是文件,文件可以被改写,改写不需要 GPU,也不需要重新训练。
一句话:它把「模型能力」和「模型周边的工程」彻底切开,只动后者。这也意味着它的收益上限,取决于你的瓶颈究竟在模型还是在壳。
不微调,也不做强化学习
视频里用了一个很直观的说法:权重全程冻结,一个字节没动。这话不是修辞,是论文的前提假设。Harness² 明确写着自己「keeps model weights fixed」,改的全部是模型外部的东西。
为什么不走微调或 RL 这两条老路?论文给的答案是两个具体的困难,而不是「微调太贵」这种笼统说法。
第一,开放世界里没有标准答案。真实任务在 harness 设计阶段往往没见过,测试时是全新的,因此不存在可靠的 ground-truth verifier 来指导在线修改。你不知道正确答案,就没法用监督信号去调参数。
第二,RSI 过程高度任务特化。就算你在某个任务上把壳调好了,这套改法也常常迁移不到新场景——每次都要从零再来一遍。
这两个困难合起来,正好解释了为什么它选择「改文件」而不是「改权重」:文件可以针对单个任务即时改写,也可以被记录、被复用、被跨任务携带;权重做不到这一点。
八个可编辑组件,各自管什么
Harness² 把模型外面那层壳拆成了八个可编辑组件。这是全文最实用的部分——就算你不用这个框架,这张清单也可以直接拿来审视自己手上的 agent 项目。
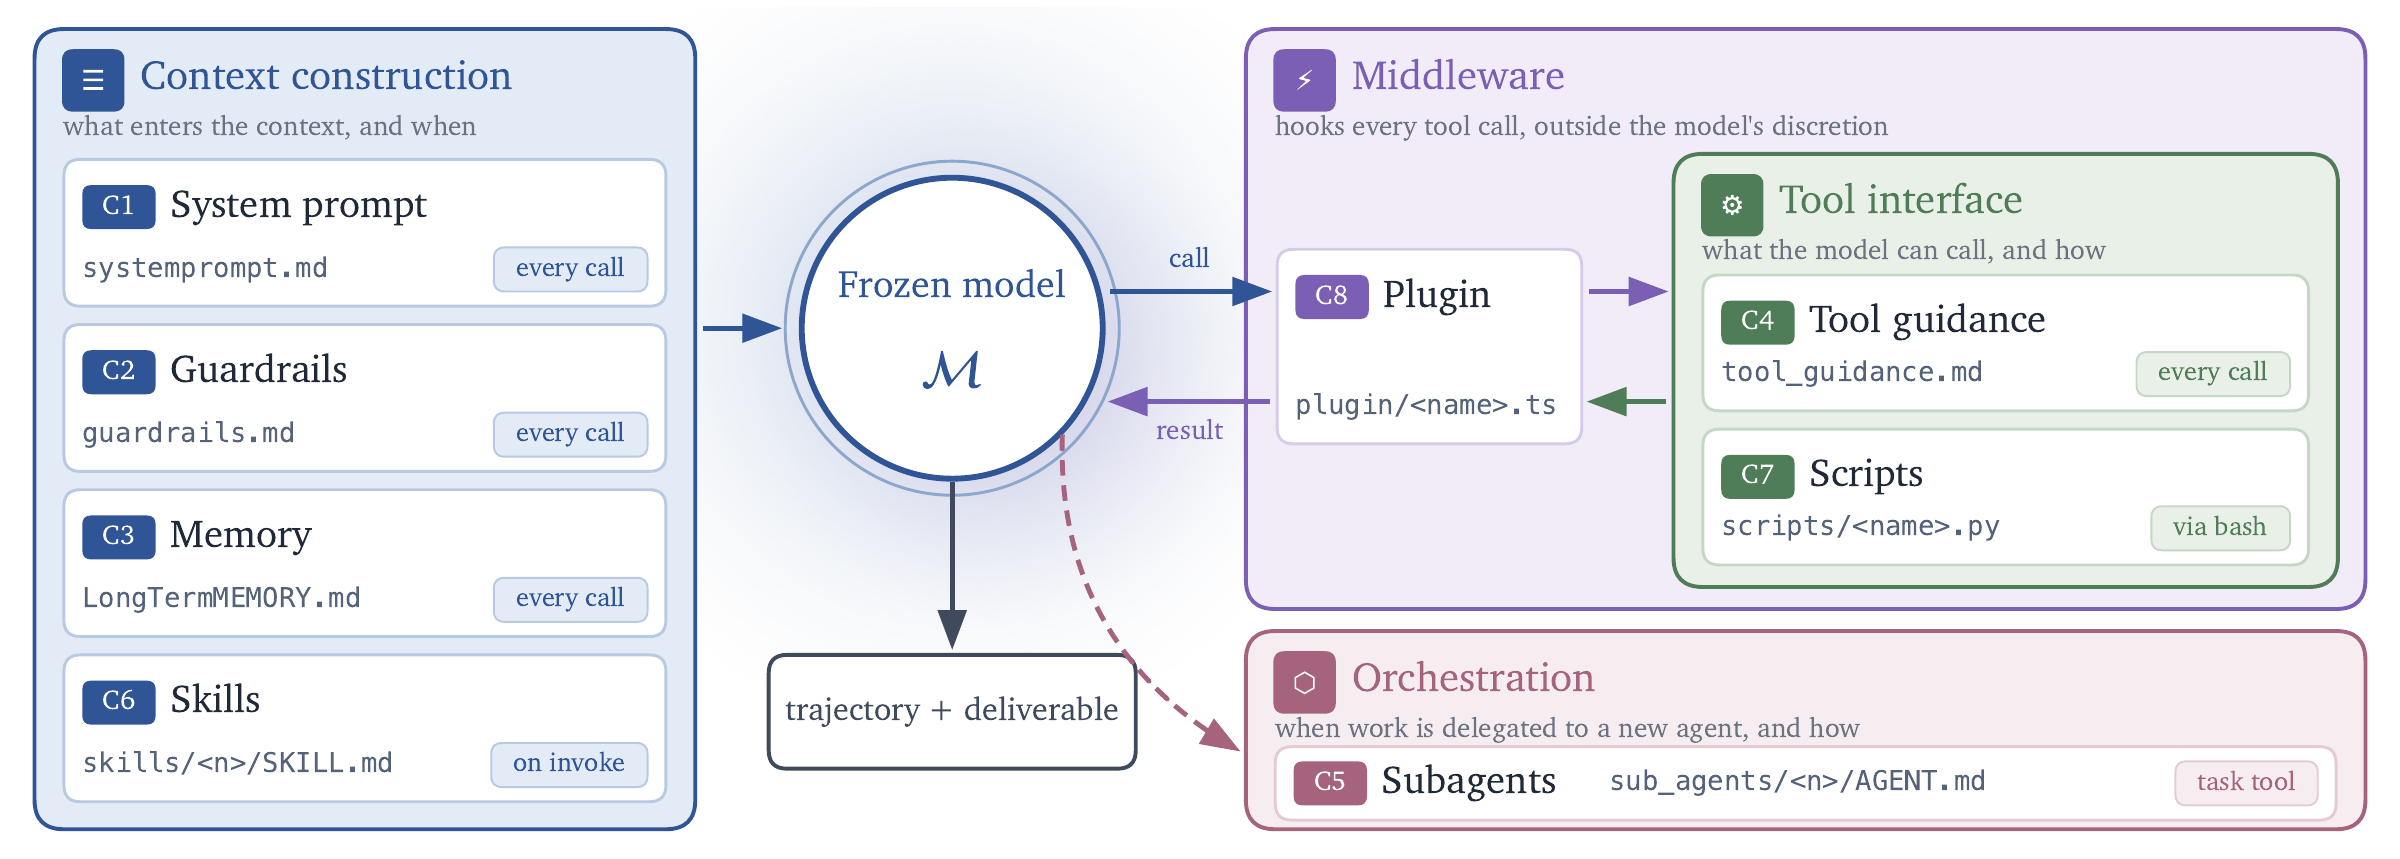
| 编号 | 组件 | 对应文件 | 什么时候生效 |
|---|---|---|---|
| C1 | System prompt 系统提示词 | systemprompt.md | 每次调用 |
| C2 | Guardrails 护栏 | guardrails.md | 每次调用 |
| C3 | Memory 记忆 | LongTermMEMORY.md | 每次调用 |
| C4 | Tool guidance 工具指导 | tool_guidance.md | 每次调用 |
| C5 | Subagents 子智能体 | sub_agents/<n>/AGENT.md | 任务委派时 |
| C6 | Skills 技能 | skills/<n>/SKILL.md | 被调用时 |
| C7 | Scripts 脚本 | scripts/<name>.py | 通过 bash 执行 |
| C8 | Plugins 插件 | plugin/<name>.ts | 钩住每次工具调用 |
四个组件负责构建上下文(提示词、护栏、记忆、技能),两个负责工具接口(工具指导、脚本),一个负责编排(子智能体),一个负责中间件(插件)。官方对插件的描述值得单独注意:「hooks every tool call, outside the model's discretion」——它钩住每一次工具调用,而且不受模型自由裁量。这是唯一一个能强制执行、模型绕不过去的部件。
读这张表的方式:如果你手上的 agent 出问题,先看是哪个部件没写。提示词写了但工具指导没写,模型就会知道该干什么、不知道怎么干;工具指导写了但护栏没写,它就会在能干的范围里做你不希望它做的事。
Propose–Probe–Compose 三步
第一层递归是任务级递归:针对当前这一个任务,把执行用的 harness 改好。它走的是一个叫 Propose–Probe–Compose 的对比流程——提议、探针、合成。
官方原文对这个流程的定义很精确:先提议改动,再探针这些改动在同一个任务上的效果,最后根据几次执行之间的行为对比把改好的 harness 合成出来,全程不需要 ground-truth 反馈。
关键在于「不看标准答案,只看行为差异」。视频里那两条曲线就是这个意思:改法 A 针对通用短板,改法 B 针对领域专用;两版都真跑一遍,谁的轨迹更顺就留谁。你不需要知道最终答案是什么,只需要能判断哪一版的执行过程更像样。
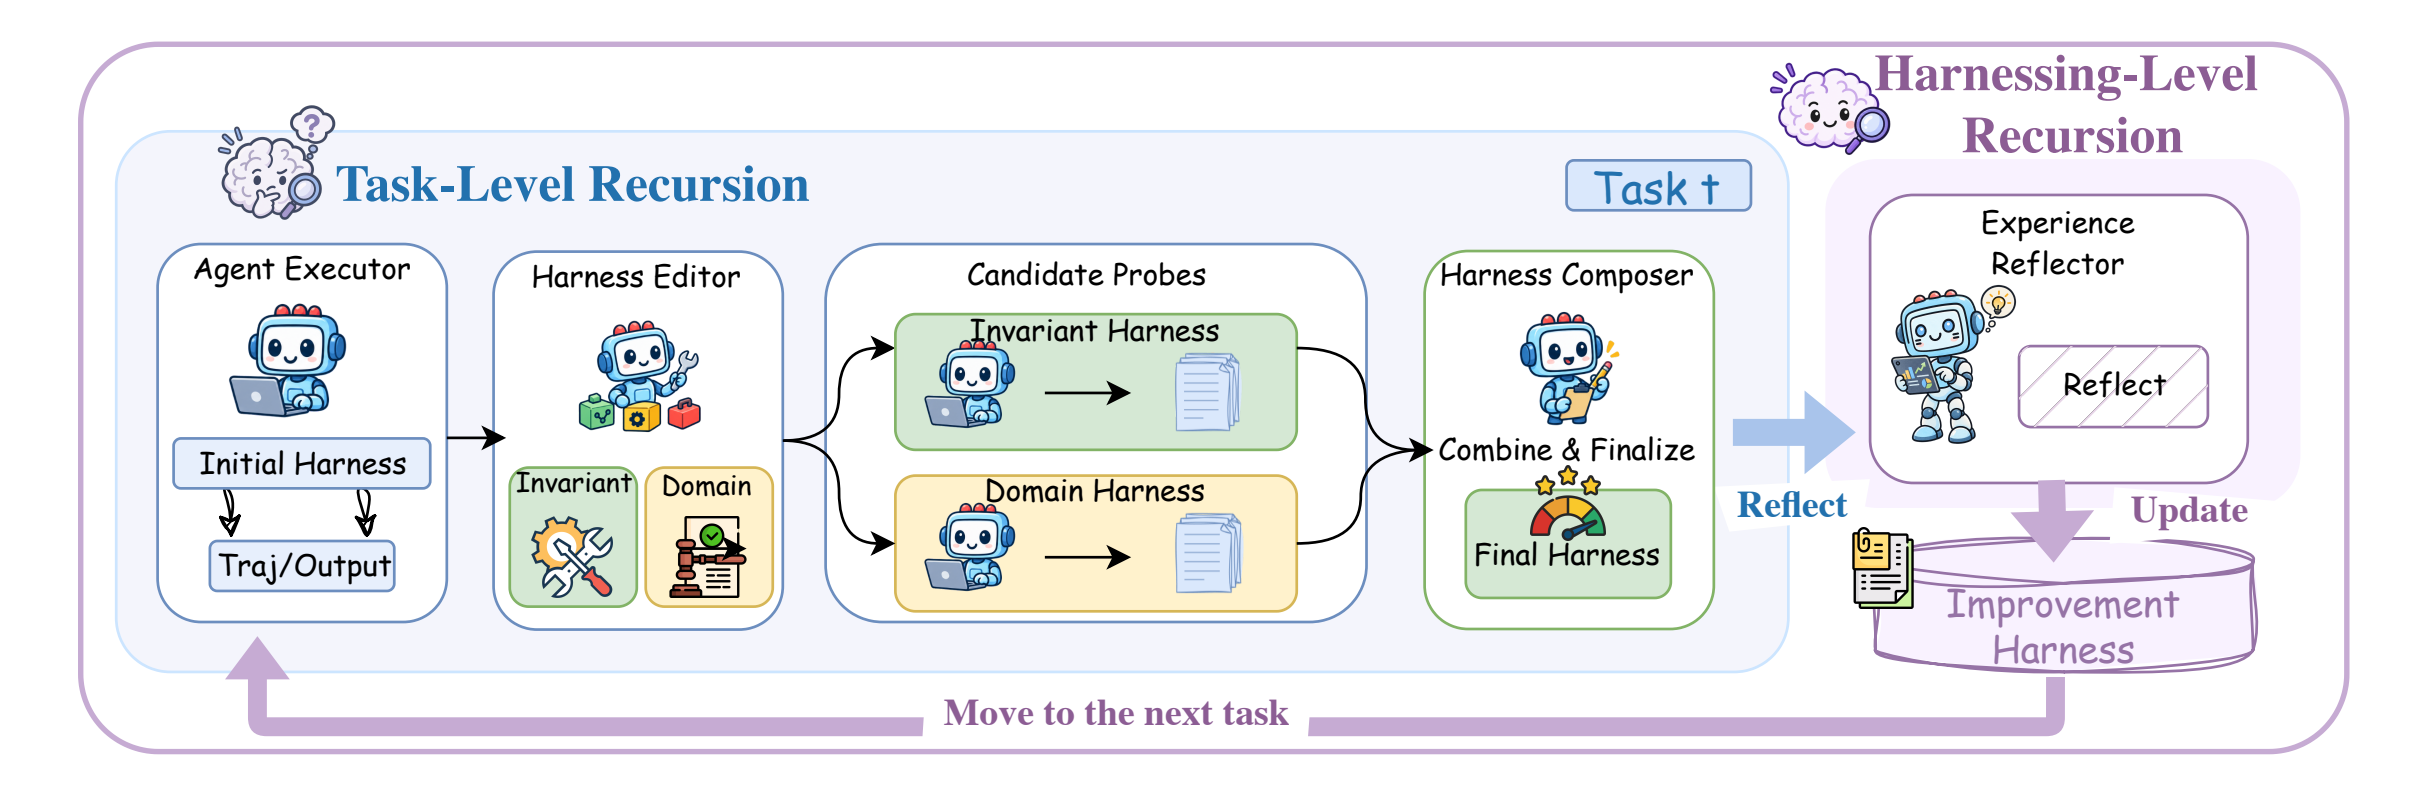
这里有一个设计上的取舍值得说:它把改法明确分成两类——invariant harness(不变量,即通用短板:规划、用工具、分工)和 domain harness(领域专用:流程约束、验收标准、术语)。两类分开探针,再在 Compose 阶段合成。好处是你能看清涨的分到底来自「通用能力补齐」还是「领域知识注入」;坏处是每一步都要跑两份,成本直接翻倍。
并行还是串行:论文说任务级递归可以「scaled further via parallel or sequential recursion」——并行多跑几条探针分支,或者串行一轮轮加深。并行更贵但更快出结果,串行更省但轮次多。
第二层递归:经验库
只有任务级递归的话,每个新任务都要从零改一遍,这正是论文点名的第二个困难。第二层递归——harness 级递归——就是为此存在的。
它的做法是维护一个持久的 improvement harness:把每个任务里被采纳的 harness 和「有证据支撑的经验」写进去,用来指导下一次改。视频里管这个叫「经验库」,对应 EXPERIENCE.md 索引,按任务取用。
两层递归的分工可以用一句话概括:任务内改一版,任务间攒一本。内环解决「这个活怎么改」,外环解决「下次遇到类似的活,从哪儿开始改」。
权重冻结的自我改进,改的不是模型,是模型与任务之间那层可读、可写、可回滚的中间层。
涨了 11.5 分,但别只看这个数
官方口径是:在三个专业 benchmark、四种模型–harness 组合上,单步 Harness² 就能让 GLM-5 和 Gemini 3.5 Flash 相对各自的 base harness 提升,最高 WorkBuddy-Bench +11.5 分、JobBench +4.5 分、LAB 部分通过率 +11.8 个百分点。论文还说,加大任务级递归的预算还能继续涨。
这几个数字都是真的,来自官方仓库与论文。但有几个限定条件必须一起读:
- 是单步(a single step)。不是跑满所有轮次的总收益,也不是「无限递归会无限涨」。
- 权重冻结、只改外壳。所以这些增益全部来自工程层,不是模型变强了。
- 只在三个 benchmark 上验证。WorkBuddy-Bench、JobBench、LAB 都是专业任务集,不等于你的日常场景。
- 模型越弱,套壳涨得越多。视频里那张对照表很有信息量:弱执行器 + 新壳 75.7,强执行器 + 原壳 72.4——弱执行器受益更大。反过来读就是:如果你本来就在用最强的模型和最好的壳,边际收益会小得多。
仓库本身的状态也值得看一眼:google-research/harness2,Apache-2.0,2026 年 10 月 6 日创建,一周多就攒到一万六千多 star——热度很高,但也很新,Issues 只有二十几个,说明大规模实战检验还没发生。
想跑起来,得先准备什么
官方给的安装路径是 Linux + Python 3.12 + uv。有一个很友好的设计:本地 demo 用确定性 editor 加真实 Python 执行,不需要任何模型凭据,可以先跑通流程再决定要不要接模型。
但如果要跑真实 benchmark,门槛就上来了:还要 Node.js 20+、Google Cloud CLI;LAB 需要 Pandoc 和 Poppler,WorkBuddy-Bench 需要 Docker;模型走 Vertex AI,得 cp .env.example .env 再配 project 和 model id,然后 gcloud auth application-default login。官方也明确写了「Model-backed runs incur API costs; start with a small task selection」——先用小任务试。
成本这一块,评论区说得比官方直白。视频底下被点赞的几条都在算 token:「那得多少token」「花费token²」「然后发现什么都要记下来迭代,每轮对话直接爆炸」。这些话不能当结论,但指出的方向是对的:每一轮探针都是一次真实执行,两份改法就是两次,k 轮就是 2k 次。省下来的训练成本,会以推理成本的形式还回去。
三类人,三种答案
如果你正在做 agent 产品,并且已经被「每次换个任务就要重调提示词」折磨过,这个框架值得读一遍源码——不是因为它的数字,而是因为它把「外壳」这件事拆成了八个有名字、有文件、可版本管理的部件。这个拆法本身就是收获。
如果你只是想让手上的 agent 表现好一点,先别急着上框架。按第 03 节那张表自查一遍,把缺的组件补上,收益可能比跑一轮递归更大,而且成本是零。
如果你在做需要长期演进的垂直 agent,第二层递归的思路最值得抄:把每次调优的经验固化成可检索的条目,而不是留在某个人的脑子里。这件事不需要 Harness² 也能做,一个 Markdown 文件就够开始。
至于「AI 界的 RSI 来了」这种说法——RSI(递归自我改进)确实是这篇论文的核心词,它也确实在做递归自我改进。但改进的对象是外壳,不是模型本身。把这两件事混在一起,就会高估它,也容易在真正该用的时候错过它。